⋯ 已提交 AI 生成深度整理,预计需要 10~60 秒(取决于文字稿长度),请稍候…
▸ 原始转写文字稿(4731 字符)
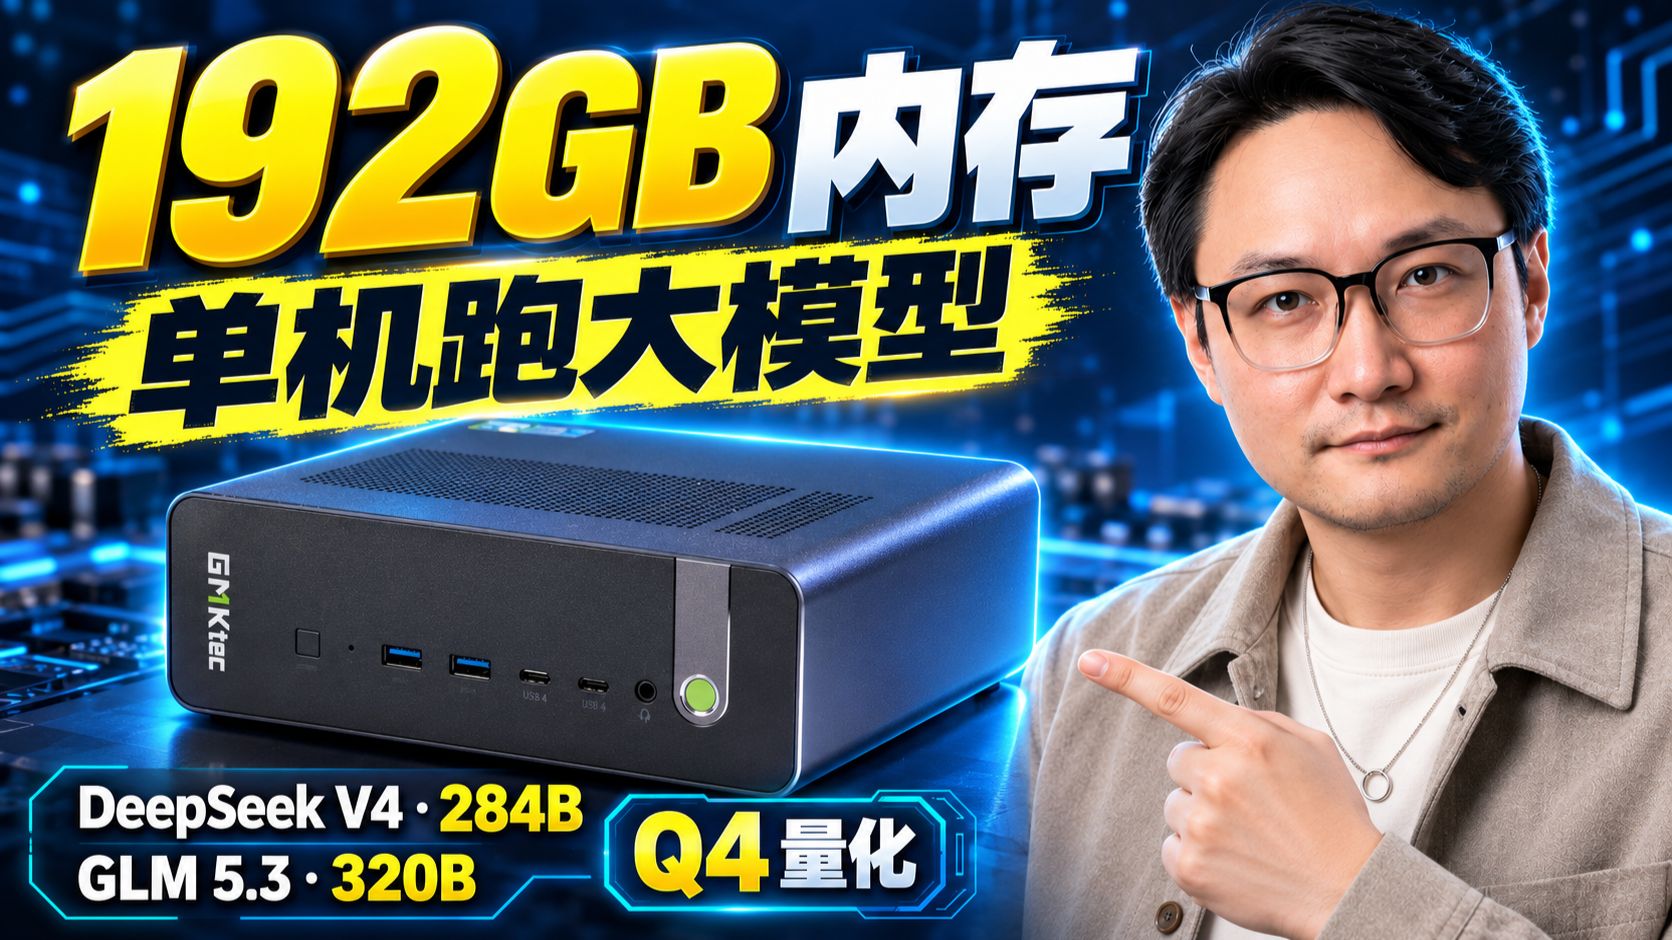
192GB的统一内存,是的,这台机器的内存,可能比你家电脑的硬盘还要大,这台是极摩客的EVO-X5,它已经能够把DXV4 FLASH的UDQ式模型全程加载到GPU,让你在家也能够拥有一条私人的大鲑鱼。甚至是320B参数的GLM5.3 FLASH,也能够在这台机器上完成本地的问答,除此以外,这台机器还有一个更加实用的用法,那就是接近180B参数的千问3.8 FLASH NES,在这台X5上,特定的引擎,可以把KV10开到约3兆TOKEN,那这是395的3倍,百万TOKEN上下纹理,全程的组织速度可以达到每秒60克,那这些到底是不在纸面的宣传标语还是真正能用,那今天呢,我就带大家来看,和之前扁平铺的较开的这个X3相比,X5回到了更常见的小主机造型,两个宽面有较为充裕的三个开孔。整机外壳使用了一体成型的铝合金中框,前后面板则为塑料材质。正面这颗绿色的电源键指纹解锁,智商使用会更加方便。机器在纵向和横向的底边都设有向寮软垫,横着放你可以放在显示器下方,而竖着放呢则更省桌面的空间。整机的体积只有3.4升,而裸机重量则为2.5公斤。机器前置有两个USB-A,两个USB-C和耳机接口,背面则给了双万张网口,模型和素材都放在NAS上的话,考到本机会更加方便。同时还有双USB-4 VR,也能够用于连接高速的外设。网上还有魔改实现了双机RDMA互联的一个方案,大家可以参围部有大面积通风孔,那实际的性能释放我们接着看曲线。整机的拆解也不算复杂,我们卸下背部的盖板,然后再取下固定内档的一个贴片,就能够把主板从前方抽出来。主板正面上方是处理器的双波轮散热,那覆盖超过80%的主板面积,底部还有一枚风扇,而三条M2R插槽也在这一面,插槽的规格大家可以看画面所示。苍武搭载的是一颗Ryzen AI Max Plus Pro 495处理器,那平台代号也从Stream Halo变成了Gorgon Halo,CPU依然是16个Zen 5核心,32个线程。相比395,基础频率从3.0提到了3.1GHz,那最高的加速频率则从5.1提到了5.2,各增加了100MHz。接下来先看持续性能释放。CPU-Z压力设施里面,我们封装功耗一开始是冲到了154W,随后则稳定在120W。长时间烤机,温度会来到97-98度,有效频率仍维持在约4.5GHz。进入这个压力平台之后,我们立刻连续跑了三轮CPU-Z,和此前的冷机成绩相比,多核相差约为1-3%,没有出现持续的一个调分。难道这么小的一台机器里面,满负荷120W运行,那这个释放是非常激进的,但能够稳住其实也非常不容易。而且这台机器的风扇,主观的听感并不算吵,适合放在房间里面提供算力服务。其他几项CPU测试的成绩我们也汇总在图里面,金默克的EVO X5的处理器性能和满血版本的395基本上处于同一个水平,这个性能放在小主机里面依然是旗舰的配置。机器的核显从8066S换到了8065S,仍然是40个计算单元,频率从2.9升到了3.0,NPU则算力从50提到了55Tops。内存的速率从之间的8000提到了8533,标升的带宽从256提升到了273Gb每秒。这几项整体的增幅都并不算大,在COMPUI通用引擎的图片视频生成测试里面,SDXL Korea 2 ZMH的热跑速度比395快约7%到13%,Midimax X3视频生成使用SLA最优的一个配置后比395要快约8%。这里我们把同一批官方工作流的耗时放在图里面,具体差距大家可以看一下。至于本地大模型,同批的拉码测试里面,495的输入处理比395快约1%到16%,而解码速度则基本上持平,两边主要还是卡在内存带宽上面。整体测试重迷模型仍受内存带宽的一个限制,而小型M1配上MP投机解码之后,更容易做到可用的速度。总对来说,更大的统一内存,主要能够给到模型权重和KP缓存,留出更多的一个空间。和之前的这个3Halo一样,495仍然是X46平台,可以直接使用Windows。你可以把它当成一台普通的PC,同时在本机跑模型、生存图片和视频。那日常使用呢,你不需要先换一套招呼系统。值得一提的是,Windows下5495对这个Valkan和自家的Rawken都有很好的一个支持,在通用的AI工作流里面,和Linux下的一个性能差距并不算大。软件方面,木马人、LMStudio这类工具提供了公共界面,CompifyUI也有适配AMD平台的一个桌面运行方案,选好对应的版本和后端之后呢,安装配置完成就能够使用。入门的门槛比重头搭建环件要低上不少。游戏也可以直接通过Steam安装,那这个核显呢,有兼顾2K游戏的能力。一句话总结就是,这系列平台在Windows下能用也好用,对普通用户是比较友好的,这也是它的一大优势。好了,那大家也看到轻一些的这个通用任务里面,495和395大多数呢,都处于同一个性能档位,但真正拓展玩法的,仍然是统一内存从128GB增长到了192GB。那接下来呢,我们就来看几个能够体现495特点的玩法。首先是官方宣传的这个离线模型规模上线已经达到了320B,而我们呢,也确实在Windows下跑通了DCB4Flash和GLM5.3Flash。接下来我们直接看这两套配置的一个实测表现。先看DCB4啊,那我们这轮用的是相对高规格的UDQ4KXL版本,全程文件约为155GB,推理我们则用的是LAMA的Valken后端,日子里面显示44层全部加载到GPU,GPU模型的一个缓存区约为144GB,也就是说192GB的容量在这里有了直接的用途。284B参数啊,一条放在家里的这个私人大匪鱼,那我们来试用一下,我们让它审核这份评测的一个脚本,也测试了结构化的一个输出,简单的Python代码和工具的选择,所测的追审,代码用力和工具参数都能够直接完成,逻辑题最终的答案也是对的。短提示下,它的图示速度大约为每秒16到17个Token,那第一次把10K左右的提示识交给它,冷读的速度约为每秒109个Token,那开始响应呢只要等到97秒多,那这个等待呢还是非常明显的。好了,读完之后继续追问呢就会轻松多了,第二第三轮我们只需要心算27和31个Token,开始响应都只需要约1秒左右,三个问题的答案也都正确啊,那画面里面我们保留元素的一个过程,大家可以直接感受冷读和追问的一个差别。总的来说,如果你只是跟模型自常对话的话呢,这个prefue性能并不会让你感到太大的障碍,那只是需要大量注入或者是调用工具之类的场景,那等待的时间就会比较长了。那接下来呢我们看到这个GLM5.3 Flash,GLM5.3 Flash是智朴目前主力的开源高速罗型,它的参数量是320B,而由于我们这次用的是IQ4 XS的量化版本,反而权重容量跟DCV4 Flash是几乎一致的,加上后短期词输出约为每秒15个Token,速度对于对话来说也算是将来够用。当然如果你能够接受慢一点的速度,那这个生存效果也并不只是能跑,我们将D-SIP和GLM挂在DSH上,各自用一具提示词生存提呼其单车的动画,那两个模型生存的效果如画面所示,本地模型能够生存这样的效果是不是还挺不错呢?就我们补充两句,在Windows下系统对于统一内存的管理是较严格的,必须预留32G给到系统,款模型实际能够使用的统一内存容量为176G,这也会导致留给三小纹的容量变少,所以要跑这类贴着极限的模型,那最好还是使用Linux系统,使用Linux下两个模型的解码性能与Windows基本一致,而Prefuse性能则会强上不少,另一方面两个模型也都可以开启头记解码,开启之后解码速度还会有10%到20%不等的提升,如果你真正打算日常高强度使用的话,甚至拿来做OpenCraws这类AI agent的一个主模型,那我呢其实会把重点放在接下来的这个千问3.8 Flash Next方案上面,Agent每一轮都要处理对话历史和这个工具返回,那输入的这个处理速度和土色速度和长上下纹的一个能力,都会直接影响他干活的体验,接近180B参数的这个模型,那前段时间呢我们自己也是在这个395 128G的这个X3上面部署过,那这里其实我们用的是一套大神专门为Stream Halo优化过的这个模感引擎,它的名字叫HeroGen,大家有兴趣的话也可以去看一下点一个赞点一个like,那我们这次呢也是把同一套HeroGen搬到了192GB的495上面,这段模型在395上它的一个平均土色速度约为59个,而495在同一个引擎下呢,8K到32K的一个上下纹土色速度均可以维持到66到69个,这里大家可以看一下它实际在DSH里面的碰子速度,感觉还是相当不错的,那当我们这个上下纹长度拉到百万级别的时候呢,495的这个代码和常温两个设置点,土色的速度仍有每秒60到62个,而prefuel呢则依然可以达到1300以上,这里我们也做了一个100万上下纹深度扫描的测试,那这个测试方法跟前面会有一些区别啊,前面我们测试的是实际100万上下纹一次注入的平均速度,而这次呢我们测的则是每个上下纹节点实际的注入速度,而解码这边我们则用的是比较中和的上下纹提示词,总的看来100万上下纹仍有600的一个prefuel和接近50的decol还是相当能打的,加上缓存的应用,那即便我们这个模型用在AI Agent上面,每轮也有很好的一个响应,我们工作室也经常会把它挂在Dixit Harness里面,完成一些长城的任务,非常的实用,而且在这个HeroGen里面,495可以把这个KV池开到315万个token的位置,使用的内存约为86G,那这个KV池呢,它的容量是395的三倍,日常使用我们可以配16个绘画槽,而并发速度则可以达到135以上,放到满上纹的场景,395只能够容纳一条接近百万token的一个请求,那495的池值可以接纳三条,这也代表这台机器完全可以提供,三个内网里面相对完整的180B模型的服务,即便是同时解码输出,它的速度也能够达到30到40token每秒,那除了单个模型可以装很大以外呢,这个192GB还适合让几套服务来进行待命,比如说我们可以画128GB给到前面这个HeroGen,让它负责这个写代码,整理资料做主模型,接下来我们还可以部署一个Holo4 35B A3B之类的一个Computer Use模型,负责专门用来看屏幕和操作桌面,那也可以让主模型常做,同时给这个CompiUI留一份内存,那我们的主模型在需要的时候,也可以直接调用CompiUI来深涂深视频,当然这个用法并不是说128GB绝对用不了,只是说余量会更紧一点,192GB则会更加有余裕。那最后我们来总结一下,从这个硬件设计看来呢,G-MOK的Evo X5在这么小的尺寸里面,实现了稳定的120W的功耗释放,做工也有不小的一个提升,我认为是可以点个赞的。而新的495处理器,统一内存拉到192GB的一个容量,让玩法得到了很大的扩展,能够在单机实现GPU完全加载的G-M和DCV4这个量级的模型,且实现流畅的优质上对话,这个相当厉害。另一方面我个人觉得非常有价值的是,它能够在本地跑,提供三人满血使用的千问3.8 Flash Next,无论是解码,玉田充,并发还是总的这个KV词,都达到了一个非常好的平衡,这也让它在企业应用中,应该可以达到一个实用的水准。当这台机器官方还提到了有5G20G的一个集训玩法,这个我们还没有来得及尝试,只能说未来再给大家进行介绍了。好了,那今天的视频内容就到这里,喜欢的小伙伴帮点赞投币关注一波,测试这么多的数据也真的是很不容易啊,也请大家多多点赞支持,那我们就下期再见咯,拜拜。